De fleste n8n-guider viser, hvordan du forbinder to noder. Få forklarer, hvorfor de skal forbindes præcis sådan: hvorfor et loop skal have batch-størrelse 1 og ikke 10, hvorfor der er to kvalitetstjek i stedet for ét, og hvorfor et regneark nogle gange er det rigtige valg og andre gange ikke. Denne artikel er gennemgangen af hvorfor. Den bygger på et rigtigt n8n workflow, jeg har bygget for en kunde til automatiseret, AI-drevet content-produktion.
Kort fortalt
- Et godt AI-workflow er bygget op i fire faser: input-gate, kontekst, generering og output-gate.
- Regler for compliance, tone og målgruppe ligger i separate dokumenter, adskilt fra selve logikken.
- Modellens egen vurdering af sit output er en rutefordeler og ikke en kvalitetskontrol. Et menneske læser altid med.
- Google Sheets er det rigtige valg, indtil volumen, samtidighed eller krav til dokumentation gør en database nødvendig.
Artiklen handler om arkitekturen og ikke om opsætningen node for node. Den finder du i guiden til at bygge et n8n workflow med Claude. De konkrete fejl, jeg stødte på undervejs, har jeg samlet i 9 n8n workflow fejl fra et AI-content-projekt. Her handler det om de beslutninger, der blev truffet, før byggeriet gik i gang. De er relevante, uanset om du bygger content-automation, lead scoring eller noget helt tredje.
Forudsætning: Du har grundlæggende kendskab til n8n. Du skal ikke bygge noget undervejs.
Læsetid: Cirka 12 til 15 minutter.
Det lærer du i denne artikel
- Hvorfor et AI-workflow er delt op i faser, og hvad hver fase beskytter mod
- Hvordan du vælger mellem Google Sheets og en database ud fra tre konkrete kriterier
- Designprincipper som idempotens, rate limits og kvalitetsgates, der gælder for alle AI-automationer
- Hvordan du vælger værktøjer (n8n eller Zapier og Make, modelstørrelse og HTTP eller færdig integration) med en begrundelse, du kan forsvare
Opgaven: Skaleret indhold i en reguleret branche
Kunden havde en indholdsstrategi med stort fokus på SEO og GEO (Generative Engine Optimization, altså optimering til AI-drevne søgemaskiner og assistenter). Målet var at producere langt flere blogindlæg uden at gå på kompromis med brandets stemme eller med compliance. I en reguleret branche er en forkert formuleret sætning ikke bare en stilfejl. Den er en juridisk risiko. Det ene krav definerede hele arkitekturen: Automatisering og menneskelig kontrol skulle designes til at arbejde sammen fra starten og ikke som et problem, man løser bagefter.
Hvad er de fire faser i workflowet?
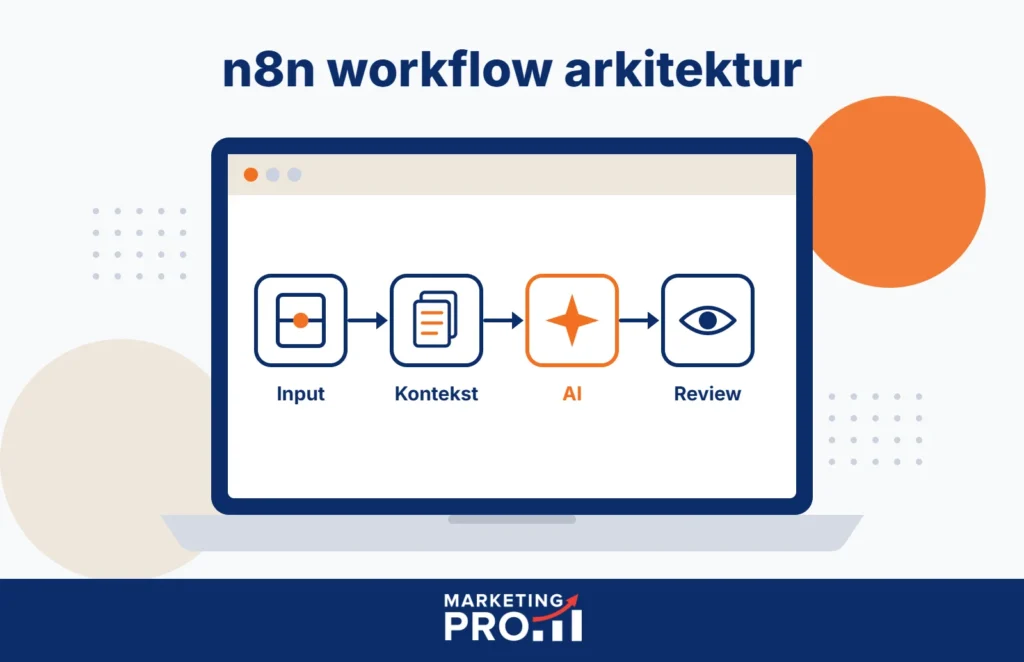
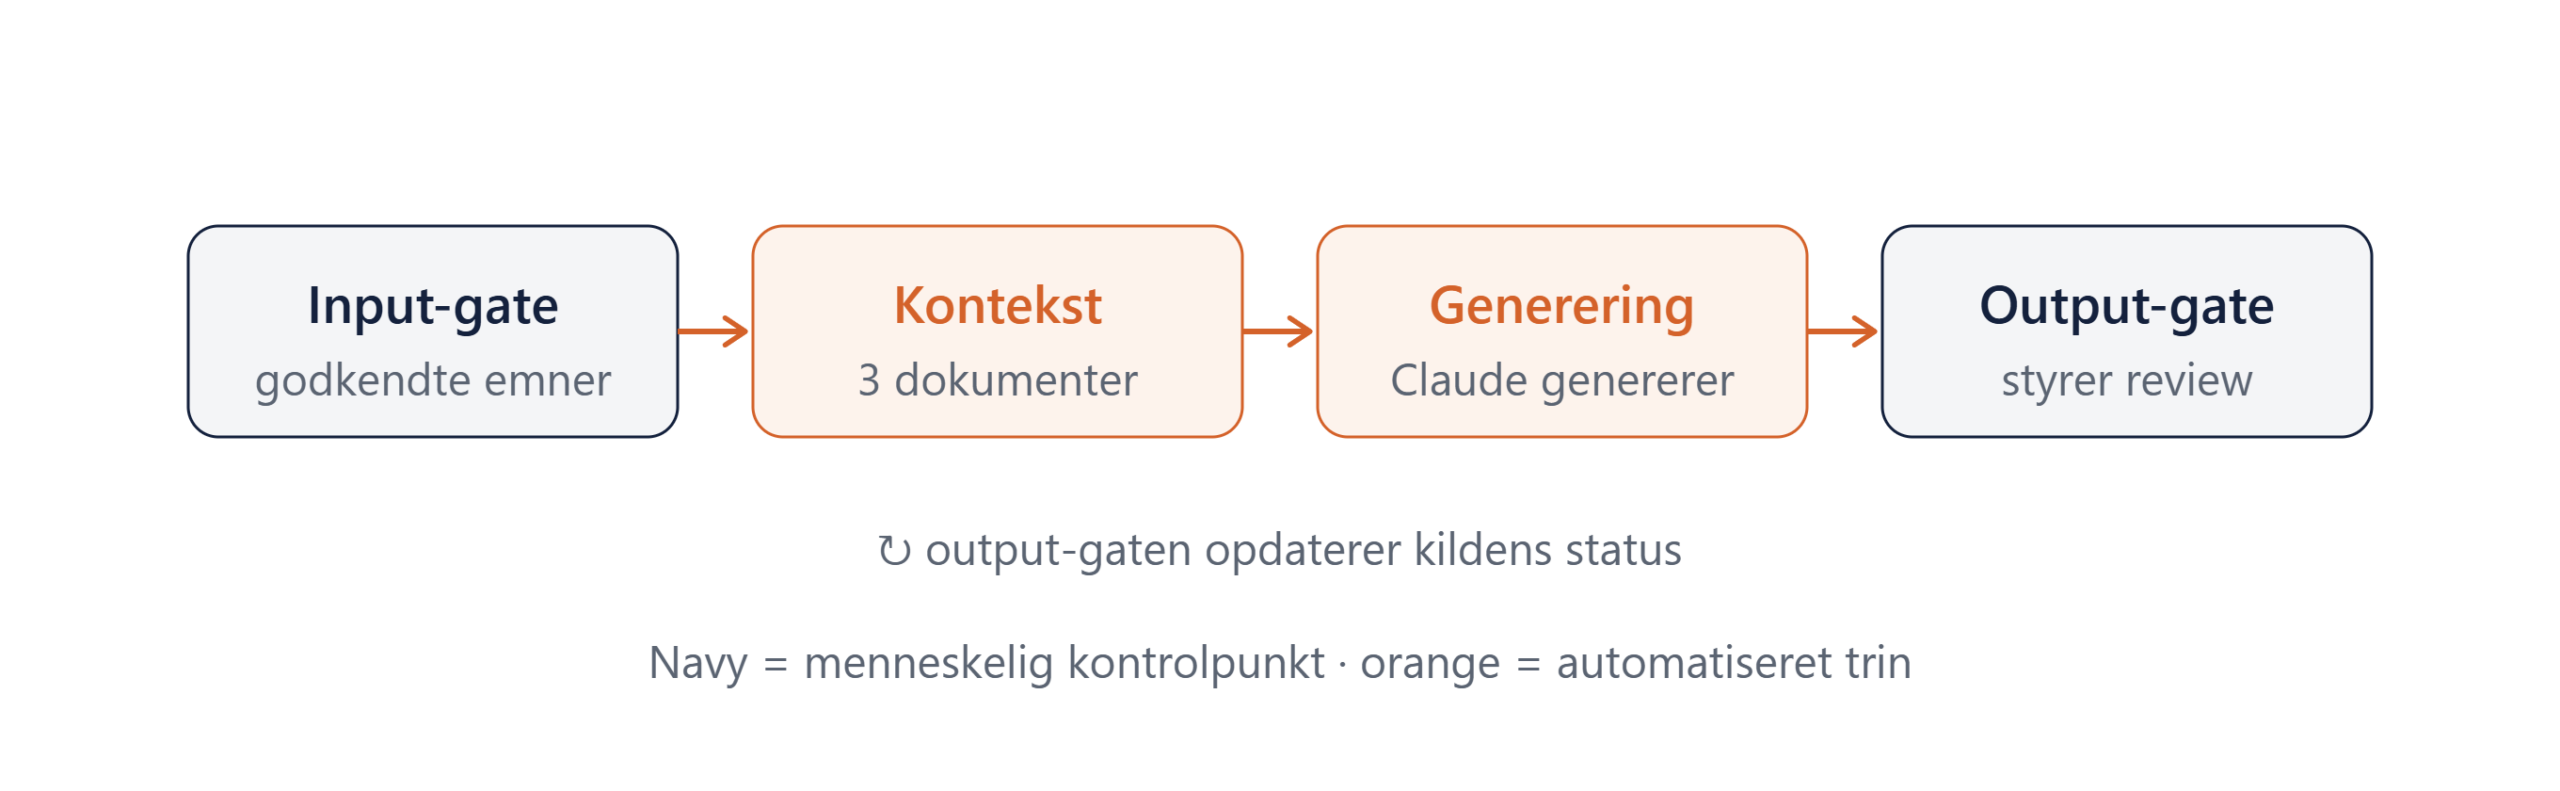
Workflowet har 15 noder, men arkitekturen består reelt af fire beslutninger:
Fase 1: Input-gaten. Hvorfor starter genereringen ikke af sig selv?
Systemet henter kun emner, som et menneske aktivt har markeret som “klar”. Det er en bevidst friktion og ikke en teknisk begrænsning. Hvis AI’en selv valgte emner fra en liste, ville systemet miste sit første og billigste kontrolpunkt: et menneskes vurdering af, om emnet overhovedet er værd at bruge tid og penge på lige nu.
Det hænger sammen med et valg, der ofte bliver overset: Triggeren er manuel og ikke tidsstyret. Det er teknisk let at automatisere, hvornår et workflow kører. Det vigtigere spørgsmål er, om det bør køre, og den beslutning er lettest at bevare, når nogen bevidst skal klikke. En daglig, automatisk trigger ville stadig kun behandle godkendte emner, men den fjerner det sidste øjeblik, hvor et menneske siger “ja, kør nu”.
Fase 2: Kontekst. Hvorfor ligger reglerne ikke i selve prompten?
For hvert emne henter workflowet tre separate dokumenter: faste regler (compliance og SEO-struktur), en guide til stemme og stil, og en kontekst for den målgruppe, emnet handler om. De kunne i princippet være ét stort dokument, skrevet direkte ind i koden. Det er de bevidst ikke, af to grunde.
Forskellige ejere og forskellige ændringstakter. Compliance-reglerne ændrer sig sjældent, men når de gør, er det kritisk. Stilguiden ændrer sig oftere, når nogen i marketingteamet finpudser tonen. Når dokumenterne er adskilt, kan en person med fagviden, fx inden for jura eller brand, rette sin del direkte i et Google Docs-dokument uden at åbne automationen.
Genbrug uden gentagelse. Fordi dokumenterne hentes ved hver kørsel, retter man en regel ét sted og ikke i hver eneste prompt. Det er et princip fra softwareudvikling: Hold konfigurationen (reglerne) adskilt fra logikken (node-kæden), så den ene kan ændres uden at røre den anden.
Fase 3: Generering. Hvorfor skal outputtet være strengt struktureret?
Claude returnerer ikke bare “en artikel” via Anthropics Messages API. Modellen returnerer et dokument med faste, navngivne sektioner: titel, metabeskrivelse, brødtekst, SEO-specifikation og en selvvurdering af, om noget kræver menneskelig gennemgang. Strukturen er ikke pertentlighed. Den er en forudsætning for, at workflowet kan pakke outputtet ud maskinelt bagefter. Uden en fast aftale mellem prompt og parsing ville hver artikel kræve, at nogen manuelt fandt ud af, hvad der var titel, og hvad der var brødtekst.
Her valgte jeg også bevidst en mindre, billigere og hurtigere model frem for den mest kapable. Ved en strengt struktureret opgave med mange instruktioner stiger kvaliteten ikke i takt med prisen. En mindre model, der følger et klart format godt, slår ofte en større model, der koster mere pr. token uden at levere et tilsvarende løft til netop denne type opgave.
Fase 4: Output-gaten. Hvorfor er der to kvalitetstjek og ikke ét?
Ud fra modellens selvvurdering deler flowet sig i to: uden advarsel går artiklen til “klar til publicering”, med advarsel går den til “kræver review”. Det er fristende at se det som kvalitetstjekket. Det er det ikke. Det er en rutefordeler, der stoler på modellens vurdering af sig selv, og ikke en uafhængig kontrol.
Den egentlige kvalitetskontrol er fase 1, hvor et menneske godkender emnet, og et menneske, der læser artiklen bagefter, uanset hvilken vej den tog. Forgreningen afgør kun, om læseren får en tydelig advarsel at kigge efter først. At forveksle “modellen siger selv, det er i orden” med “det er kontrolleret” er en reel risiko i alle AI-workflows med et trin til selvvurdering. Det er værd at sige højt, fordi systemet ser så robust ud, at det er let at glemme.
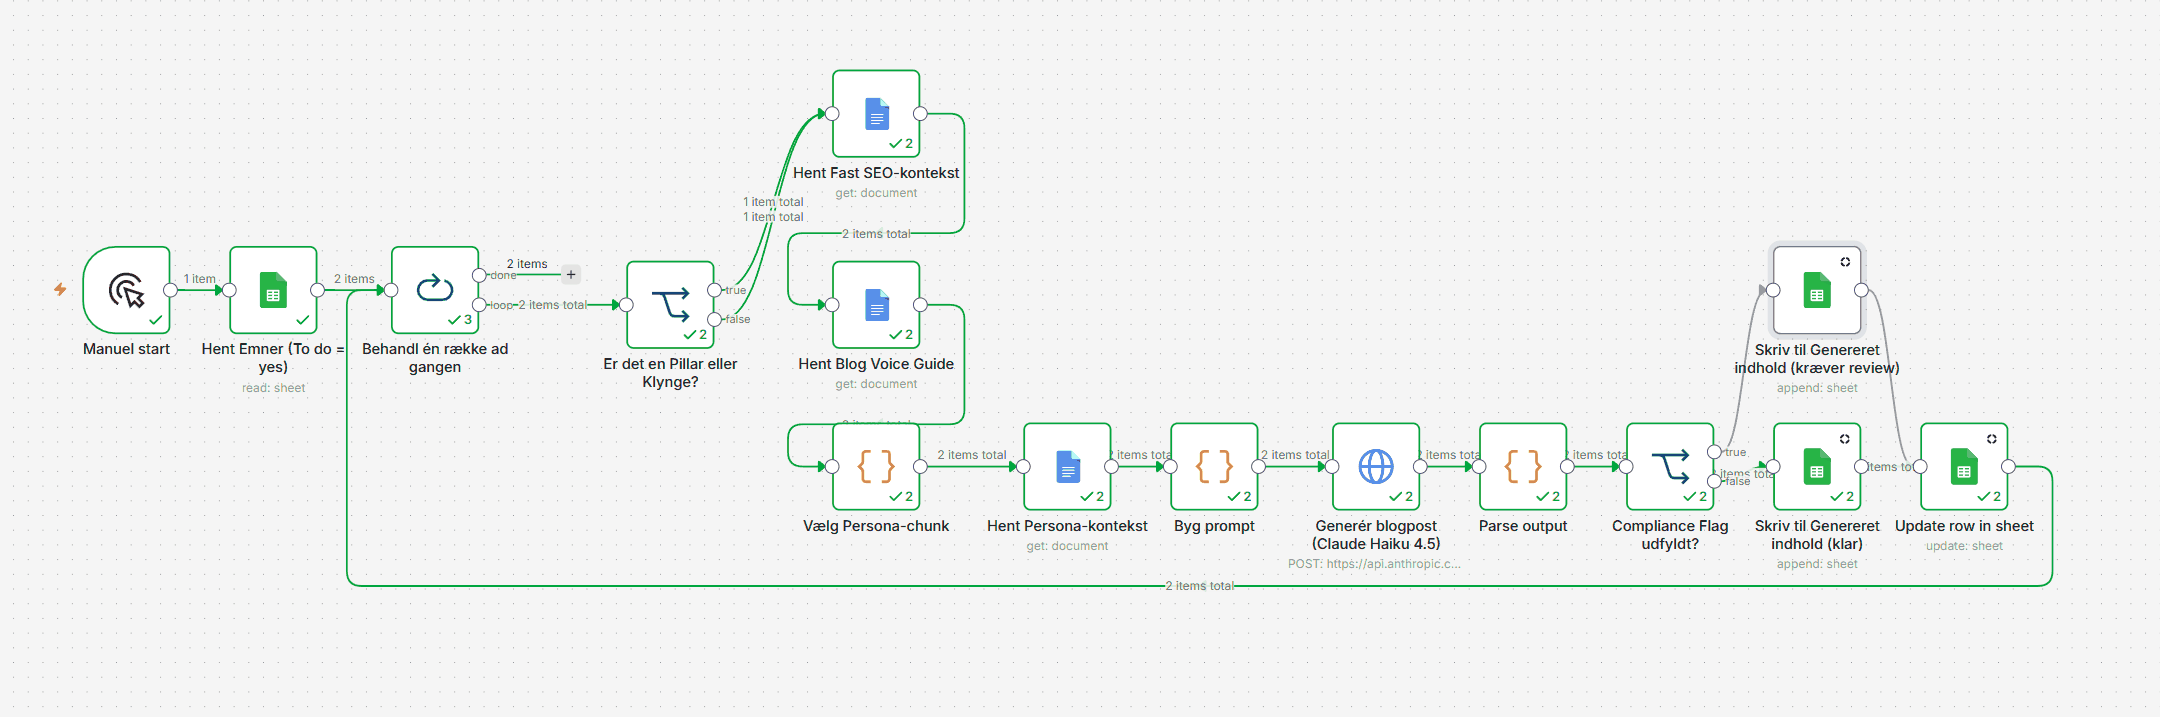
Sådan ser en fuld kørsel ud i praksis. Alle 15 noder er grønne, og begge typer indhold, Pillar og Klynge, er behandlet korrekt i samme kørsel:
Hvilke værktøjer valgte jeg, og hvad valgte jeg fra?
| Valg | Alternativ | Begrundelse |
|---|---|---|
| n8n | Zapier eller Make | Enhver node kan erstattes af JavaScript, når den visuelle logik ikke slår til |
| Claude Haiku | En større model | Pris og kvalitet følges ikke ad ved strengt strukturerede opgaver |
| Google Sheets | En database | Den rigtige løsning ved den nuværende skala (se næste afsnit) |
| HTTP Request | n8n’s Anthropic-noder | Fuld kontrol over request og svar, og ingen binding til én udbyder |
n8n frem for Zapier eller Make. De tre platforme løser overlappende problemer. Zapier og Make er stærkest, når du hurtigt vil i gang uden kode. n8n er stærkest, når workflowet har brug for betinget logik, der er for kompleks til klik og valg, uden at det skal blive et separat softwareprojekt. Til dette workflow, med dynamisk opbygning af prompts og struktureret parsing, var den fleksibilitet afgørende.
HTTP Request frem for en færdig integration. n8n har indbyggede Anthropic-noder: en Anthropic Chat Model-node til AI Agent- og Chain-mønstre og en Anthropic-node med handlinger som “Message a model”. Jeg valgte alligevel den generelle HTTP Request-node, fordi outputtet skulle pakkes ud efter et helt bestemt format. Det kræver fuld kontrol over den rå request og det rå svar. n8n’s egen dokumentation peger også på HTTP Request-noden, når den indbyggede node ikke dækker behovet. Samtidig virker samme opsætning med næsten alle andre AI-udbydere, så systemet ikke er låst, hvis priser eller kvalitet ændrer sig.
Google Sheets eller database: Hvad skal du vælge?
Mange antager, at et “seriøst” system bruger en database, og at et regneark er en midlertidig løsning. Det er den forkerte måde at se det på. Beslutningen afhænger af tre konkrete forhold:
- Volumen. Ved få rækker om ugen er Sheets hurtigere at arbejde med end en database. Ved titusindvis af rækker bliver Google Sheets’ egne grænser for API-kald flaskehalsen. Ikke fordi Sheets er for simpelt, men fordi det ikke er bygget til så mange forespørgsler.
- Samtidighed. Hvis flere personer redigerer data, mens automationen skriver i samme ark, kan en menneskelig rettelse blive overskrevet. Sheets har ingen rigtig håndtering af samtidige ændringer. En database med låsning på rækkeniveau løser problemet strukturelt.
- Krav til compliance og dokumentation. Skal du kunne dokumentere præcis, hvem der godkendte hvad og hvornår, eller styre adgangen helt ned på feltniveau, er versionshistorikken i Sheets ikke god nok.
Ved workflowets nuværende skala, få rækker om ugen og én person, der gennemgår indholdet, rammer ingen af de tre forhold deres grænse. Sheets er derfor det rigtige valg: gratis, kendt af alle og uden infrastruktur at vedligeholde. At bygge en database nu ville være at løse et problem, systemet ikke har endnu.
To principper, der gælder for alle AI-workflows
Idempotens skal designes ind. Et system er idempotent, når det er sikkert at køre den samme handling flere gange uden utilsigtede følger. Dette workflow har ét forsvar: at statusfeltet i kilden bliver opdateret efter genereringen. Fejler den opdatering uden at sige det, bliver samme emne behandlet igen næste gang, og du ender med to versioner af samme artikel. En mere robust, men dyrere, løsning tjekker aktivt, om indholdet allerede findes, før genereringen starter.
Rate limits kommer fra flere systemer. Både Google Sheets og AI-udbyderens API har hver deres grænser for antal kald, uafhængigt af et eventuelt loft over forbruget. Rammer du en grænse, får du som regel en midlertidig fejl og ikke en permanent blokering. Men uden retry-logik stopper hele kørslen ved den første grænse.
Hvorfor er test en del af arkitekturen?
Hver fuld kørsel indebærer et rigtigt AI-kald, og det tager tid under udviklingen, ofte flere sekunder alene til genereringen. At designe med test for øje betyder konkret:
- Adskil beslutning fra udførelse i separate noder. Så kan du se, om et forkert resultat skyldes en forkert beslutning eller en fejlet udførelse, uden at gætte.
- Byg et loft over antal tokens, som du kan sænke midlertidigt. Tester du kun logikken efter genereringen, behøver du ikke en fuld artikel hver gang. Et lavt loft giver stadig gyldigt, struktureret output, bare hurtigere og billigere.
- Design loopet, så test af ét emne giver mening. Fordi hvert emne behandles for sig med batch-størrelse 1, kan du teste ét emne uden at forstyrre resten af køen.
Hvad ville jeg gøre anderledes næste gang?
En arkitektur er aldrig færdig, kun tilstrækkelig til sin nuværende skala. To forbedringer står klar, hvis mængden vokser:
- Et tjek for dubletter før genereringen, så systemet ikke kun stoler på, at statusopdateringen bagefter altid lykkes.
- Caching af kontekstdokumenterne. I dag hentes de tre dokumenter for hvert emne i loopet, selvom de som regel er de samme inden for én kørsel. Ved høj volumen giver det mening at hente dem én gang uden for loopet.
Ingen af delene er nødvendige ved den skala, systemet kører på i dag, og det er netop pointen. God arkitektur passer til sin nuværende skala og har tydelige veje til at udvide, når skalaen ændrer sig. Den bygger ikke på forhånd til en fremtid, der måske aldrig kommer.
Næste skridt
Vil du bygge en enklere version af systemet selv, så start med guiden til at bygge et n8n workflow med Claude og Google Sheets. Og vil du undgå de fejl, jeg selv lavede, så læs de 9 n8n workflow fejl fra projektet.
Ofte stillede spørgsmål
Hvorfor er en manuel trigger bedre end en tidsstyret?
Fordi den manuelle trigger bevarer et sidste, bevidst beslutningspunkt, hvor et menneske trykker “kør nu”. En tidsstyret trigger fjerner ikke kravet om godkendte emner, men den fjerner det øjeblik, hvor nogen aktivt vælger at sætte processen i gang.
Er det spild at hente de samme kontekstdokumenter for hvert emne?
Ved lav volumen er forskellen ubetydelig. Ved høj volumen er det oplagt at cache dokumenterne uden for loopet. Den slags optimering giver mening, når skalaen kræver det, og ikke før.
Hvornår skal man skifte fra Google Sheets til en database?
Når mindst én af tre ting sker: Datamængden vokser, så Sheets’ grænser for API-kald bliver en flaskehals. Flere personer redigerer data, samtidig med at automationen skriver. Eller krav til compliance kræver en systematisk dokumentation af, hvem der har gjort hvad, som Sheets ikke kan levere.
Er AI’ens egen vurdering af, om noget kræver review, en pålidelig kvalitetskontrol?
Nej, og den bør aldrig være den eneste. Den prioriterer, hvor et menneske skal kigge først, men den erstatter ikke, at et menneske faktisk læser outputtet.